.MD vs .DOCX FINAL FIGHT
Un de mes sujets préférés sur l’agentique c’est comment doit-on constituer la context layer la plus efficace possible pour notre collaboration avec les agents.
Ce que j’appelle “context layer” c’est l’ensemble de la connaissance partagée qui va être consommée et produite par les agents. Quand nous n’étions qu’entre humains, la context layer était assez simple : un Drive ou un sharepoint et des fichiers bureautique qui s’échangent par mail : .docx, .xlsx, .pptx. J’exclus pour le moment d’autres entités du context layer entre humains comme les Jira, Confluence, et autre Notion qui feront l’objet d’un autre post.
Je ne vais pas m’étendre sur ce qu’on peut faire avec Word, tout le monde connait (j’ai dit “connait” pas “maitrise”).
D’un autre coté, au milieu des années 2000 est né le format markdown .md, un format de balisage léger permettant de rédiger du texte facilement lisible et d’écrire en HTML sans utiliser directement les balises HTML. Pas de logiciel spécifique à utiliser pour écrire du markdown, un simple éditeur de texte suffit : ajouter un # pour un titre de niveau 1, ## pour un titre de niveau 2, **mot** pour mettre en mot en gras, etc.
Simple quoi avec markdown, la mise en forme est directement dans le texte.
Un fichier Word, c’est un ZIP
Renommez un .docx en .zip et ouvrez-le. Vous trouverez un dossier word/ avec document.xml, des styles, des réglages, des fichiers de relations. C’est le format Open XML, normalisé (ECMA-376, ISO/IEC 29500). Un .pptx suit la même logique, avec une partie XML par diapositive.
Bon, déjà on commence à voir émerger les différences avec le .md.
Pour lire un texte en markdown, aucun problème : vous pouvez ouvrir le fichier, il se lit sans difficultés. Vous aurez juste des # devant les titres et des * pour les textes en gras ou italique. Pour voir le texte mis en forme il vous faudra un logiciel spécifique ou une web app, qui rendra la mise en forme (fun fact : l’article que vous lisez en ce moment est écrit en markdown). Vous pouvez utiliser StackEdit par exemple.
En revanche, si vous ouvrez le .zip d’un word, ça se complexifie, impossible de lire les .xml, d’une traite, il faut comprendre sa structure et faire abstraction des chevrons, et surtout, vous n’êtes pas Neo. Et c’est pour cette raison que vous utilisez Word pour rendre le document et sa mise en page.
Pour modifier un fichier word, c’est très simple pour vous, vous sélectionnez le mot à mettre en gras avec la souris et cliquez sur l’icone ou un raccourci clavier. Pour un markdown, il faut ajouter ** et ** au début et à la fin du mot.
J’ai utilisé le mot rendre plus haut à dessein : on rend les documents mis en forme pour faciliter la lecture à l’humain. On utilise word pour faire une projection d’un contenu vers un humain. L’écart entre le word et le markdown c’est qu’avec le markdown la projection du contenu est le contenu lui même
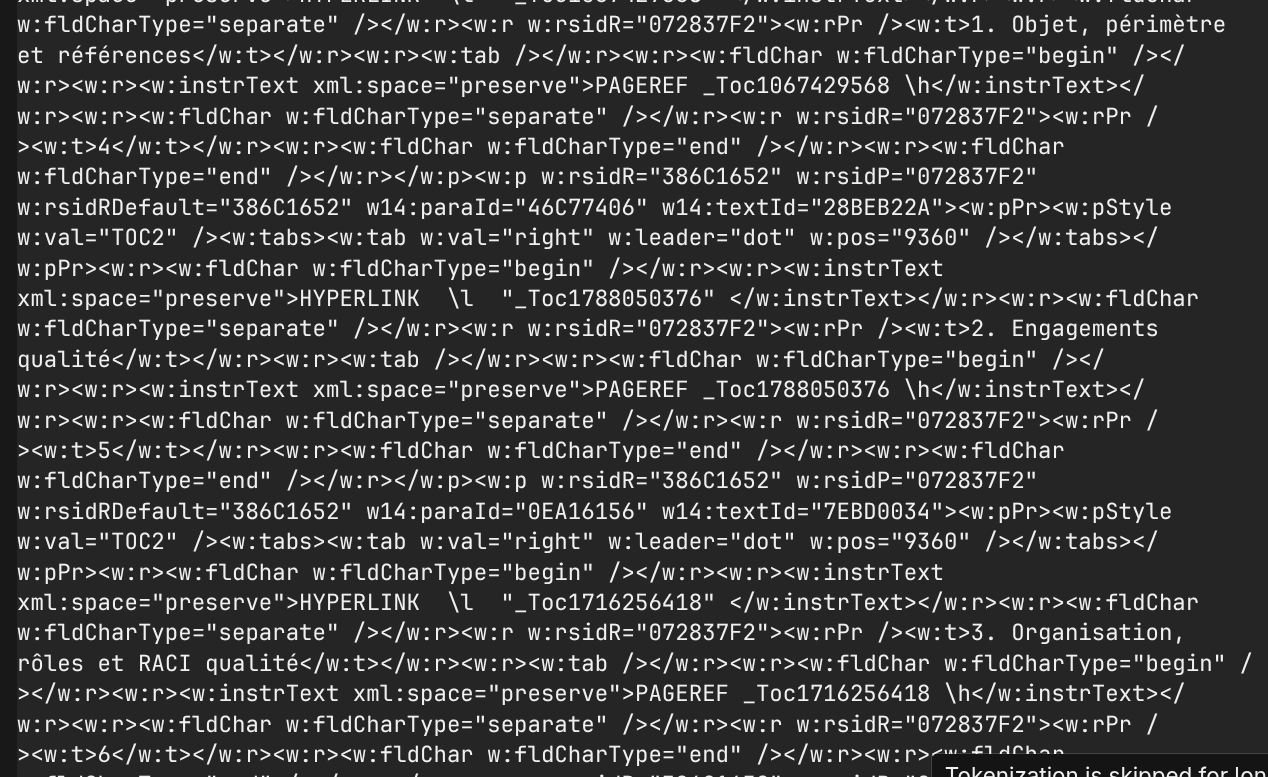
Le même mot en gras, vu par un agent
Contrairement à vous, un agent n’ouvre jamais Word (enfin il pourrait le faire, mais ce serait diablement inefficace). Il travaille sur les fichiers XML contenus dans l’archive : soit il les édite directement, soit il passe par une bibliothèque ou un script ciblé (pandoc pour lire, docx-js ou python-docx pour écrire). Dans ce second cas, c’est le code qui manipule le XML, et celui-ci n’entre pas forcément dans le contexte du modèle ni dans ce qu’il écrit.
Pour le markdown, un agent fait comme un humain, il édite le fichier texte directement.
C’est ici que ça commence à se corser. Et que je pose la question : quand je travaille avec mon agent quel format privilégier ?
Prenons une phrase toute simple : « Le budget total est validé. »
En markdown, l’agent lit et écrit ceci :
Le budget **total** est validé.
Une ligne. Ce que l’agent lit, c’est ce que vous lisez : la projection du contenu est le contenu.
Dans un Word bien construit, avec des styles, la même phrase devient :
<w:p><w:pPr><w:pStyle w:val="BodyText"/></w:pPr>
<w:r><w:t xml:space="preserve">Le budget </w:t></w:r>
<w:r><w:rPr><w:b/></w:rPr><w:t>total</w:t></w:r>
<w:r><w:t xml:space="preserve"> est validé.</w:t></w:r>
</w:p>
Déjà beaucoup plus long. Et un simple mot en gras a coupé la phrase en trois morceaux.
Mais ça, c’est le cas idéal. Dans la vraie vie, vos documents ont vécu : on a changé la police à la main, collé un paragraphe depuis un mail, corrigé une coquille trois mois plus tard. Word garde la trace de tout ça. Chaque morceau de texte se met à transporter sa police, sa taille, sa couleur, sa langue, et des identifiants de révision. La même phrase de cinq mots gonfle alors bien au-delà de l’exemple ci-dessus.
Pire, le texte se fragmente de façon invisible. Le titre « 3.2 Analyse des coûts » que vous voyez d’un seul tenant peut être stocké en cinq morceaux dans le XML. Pour l’agent, une simple recherche du mot « Analyse » peut échouer. Il doit reconstruire le texte avant de pouvoir y toucher.
Demander à votre agent d’ajouter une sous-partie
Imaginons une tâche banale : dans un document d’une trentaine de pages, insérer une nouvelle sous-partie 3.2 entre l’actuelle 3.1 et l’actuelle 3.2, qui deviennent respectivement 3.3 et 3.4.
En markdown, l’agent cherche ## 3.2, insère la nouvelle section, renumérote deux titres, vérifie les renvois du type « voir section 3.2 ». Peu d’allers-retours, un contexte léger. Terminé.
En Word, le parcours est tout autre. Premier constat : la « page 30 » n’existe pas vraiment dans le fichier. Les pages sont calculées par Word au moment de l’affichage, et le XML est essentiellement une longue suite de paragraphes. L’agent doit donc décompresser l’archive, localiser le bon paragraphe par son texte, puis comprendre comment la numérotation est faite. Si elle est automatique (un style de titre lié à une liste), il suffit d’insérer un titre avec le même style, et Word renumérote seul. Si elle a été tapée à la main, l’agent doit corriger lui-même chaque numéro, morceau par morceau. Ensuite, il doit reproduire fidèlement la mise en forme des sections voisines, penser à la table des matières, qui ne se met pas à jour seule, recompresser le tout, et enfin convertir le document en PDF puis en images pour vérifier visuellement que rien n’est cassé. Car rien dans le XML ne garantit que le rendu sera correct.
Plus d’allers-retours pour l’agent, et un contexte qui enfle à chaque tour. Sur un document qui a beaucoup vécu, avec des tableaux, des images et Patrick de la compta qui numérote à la main, l’écart se creuse encore. Le cache de prompt amortit une partie de ces relectures, en coût comme en temps. Les étapes, elles, restent. Combien exactement ? Ça dépend du document, de l’agent et de ses outils. L’annexe explique comment le mesurer chez vous.
Quant au PowerPoint, il a un petit avantage (chaque diapositive est un fichier séparé, donc plus facile à cibler) et un gros inconvénient : tout y est positionné en coordonnées absolues. Ajoutez trois lignes dans une zone de texte, et rien ne glisse : le texte déborde, chevauche, rétrécit. L’agent ne peut le savoir qu’en regardant le rendu : chaque modification devient une boucle « j’édite, je regarde, je corrige ».
Travailler dans la projection
Revenons à ma distinction de départ. Le problème, c’est que nous avons pris l’habitude de travailler dans la projection elle-même. Le .docx est à la fois notre brouillon, notre source de vérité et notre livrable.
Tant qu’on n’était qu’entre humains, ce n’était pas gênant : Word cache toute cette complexité derrière une interface. Mais un agent n’a pas d’interface. Il voit la plomberie. Lui demander de travailler dans un .docx, c’est un peu comme demander à quelqu’un de corriger un texte en retouchant directement les pixels d’une capture d’écran.
Avec le markdown, l’humain et l’agent lisent exactement le même fichier, et le comprennent de la même façon.
Markdown comme format du context layer
C’est mon combat personnel.
Concrètement, le contenu vit en .md. C’est là que vous et votre agent rédigez, modifiez, restructurez. C’est ce format qui constitue votre context layer : lisible par tous, léger à consommer, facile à versionner, facile à comparer d’une version à l’autre.
Quand il faut livrer un document mis en forme (pour un client, une direction, un comité), on génère le .docx à partir du markdown, par exemple avec pandoc et un modèle Word à vos couleurs. Le Word redevient ce qu’il aurait toujours dû être : une projection, produite à la demande, jetable et régénérable.
Il y aura bien sûr des cas où le Word reste incontournable : un document qui revient avec des modifications suivies, un modèle juridique imposé, un client qui ne jure que par les commentaires dans la marge. Dans ce cas, quelques règles limitent la casse : partir de modèles propres, utiliser des styles plutôt que de la mise en forme manuelle, activer la numérotation automatique, éviter les copier-coller non nettoyés. Un document bien stylé reste plus lourd qu’un markdown à faire modifier par un agent. Un document « sale » l’est bien davantage.
La différence est entre vos mains.
Les limites de mon combat
Le Markdown a de vraies limites : les tableaux complexes, les cellules fusionnées, la mise en page fine passent mal. Et surtout, les commentaires et les modifications suivies n’ont pas d’équivalent. Or c’est précisément ce que vos collègues et vos clients utilisent. L’aller-retour Word → Markdown → Word est destructeur : ce qui revient annoté dans la marge ne survit pas à la conversion. Ajoutons que demander à toute une équipe de passer au texte brut, c’est un vrai changement d’habitudes (même si des éditeurs comme StackEdit masquent les dièses et les astérisques). Et qu’il existe un entre-deux : des éditeurs structurés en ligne, que l’humain et l’agent modifient ensemble.
Mais regardons ce que font vraiment les modifications suivies. Elles répondent à deux questions : qui a changé quoi, et est-ce que c’est validé ? Côté Markdown, la première a une excellente réponse : Git, ses diffs, son historique, ses relectures. La seconde, beaucoup moins. Et elle devient brûlante dès que ce sont des agents qui écrivent : quand un humain rédige une page, on sait à qui demander des comptes. Quand un agent en génère dix mille dans la nuit, cette garantie disparaît.
C’est exactement le problème auquel Google Cloud s’est attaqué avec l’Open Knowledge Format (OKF). Publié en version 0.1 le 12 juin 2026, il décrit la connaissance comme un dossier de fichiers Markdown avec un en-tête YAML. Du Markdown, donc. Google recommande de le gérer comme un dépôt Git, pour appliquer à la connaissance les pratiques du code : relectures, diffs, historique. Et la version 0.2 ajoute précisément la couche de validité qui manquait : des champs qui indiquent d’où vient un contenu, qui l’a produit et quand, qui l’a vérifié et s’il s’agit d’un humain ou d’une machine, et à partir de quand il faut le considérer comme périmé. Un agent peut ainsi distinguer un contenu non vérifié, confirmé par une machine, ou relu par un humain. Google Publishes Open Knowledge Format for Knowledge Bundles
Autrement dit, le monde du Markdown est en train de reconstruire ce que les modifications suivies faisaient dans Word, mais au niveau qui compte pour un agent : non pas « qui a barré ce mot », mais « puis-je me fier à cette information ? ». Tout ça est encore jeune : une licence ouverte, mais pas encore de gouvernance ouverte ni d’organisme de normalisation derrière. Mais la direction est plutôt claire.
Ce sera le sujet d’un prochain post, avec les Notion, Confluence et autres éditeurs structurés : comment versionner et valider une context layer que des agents écrivent autant qu’ils la lisent.
ANNEXE : Mesurez avant de croire qui que ce soit
Le protocole tient en cinq lignes.
- Prenez un vrai document, en deux versions au contenu identique : un
.mdet le.docxtel que votre client l’utilise. - Écrivez une consigne unique (« insère une partie 3.2 sur X, mets à jour la numérotation et la table des matières »).
- Lancez chaque version dans une session neuve de Claude Code, même modèle, même effort, même skill installée.
- Relevez
/costen fin de session : tokens d’entrée, de sortie, lectures et écritures de cache, coût. Comptez aussi les tours. - Répétez trois fois minimum. Un agent ne suit jamais deux fois le même chemin.
Vous aurez votre chiffre, sur vos documents.